Заголовок намеренно сделан таким кричащим и провокационным, но, на мой взгляд, он недалёк от правды.
Акт 1. Волна уязвимостей
За последние полгода с небольшим мы столкнулись с колоссальной волной критических уязвимостей, которые требовали незамедлительной реакции — обновления, если исправление уже доступно, или просто отключения части функциональности.
Я связываю это прежде всего с ростом использования ИИ-агентов. Но речь не только о новых уязвимостях, которые агенты вносят в код. Они позволяют быстрее находить ошибки, которые существовали годами, если не десятилетиями, а также объединять их в цепочки эксплуатации, добиваясь опасных последствий.
Для масштаба я посмотрел, сколько записей CVE публикуется каждый год по данным CVE Program. Здесь учитываются все степени критичности, а не только критические уязвимости.
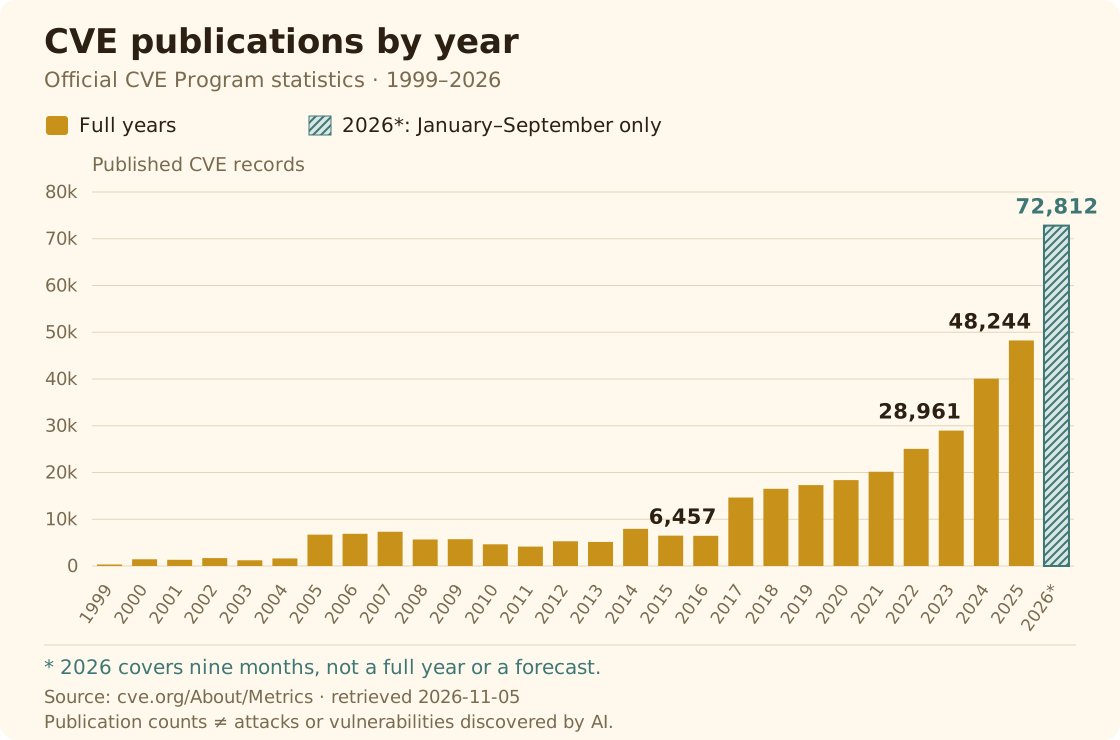
1999–2025 — полные годы; 2026 — только январь–сентябрь, без прогноза на оставшийся квартал.
Число опубликованных записей CVE за 2023 год составило 28 961, за 2024 — 40 077, за 2025 — 48 244. А за первые девять месяцев 2026 года — уже 72 812. Это на 105% больше, чем за те же девять месяцев 2025 года, когда было опубликовано 35 448 записей.
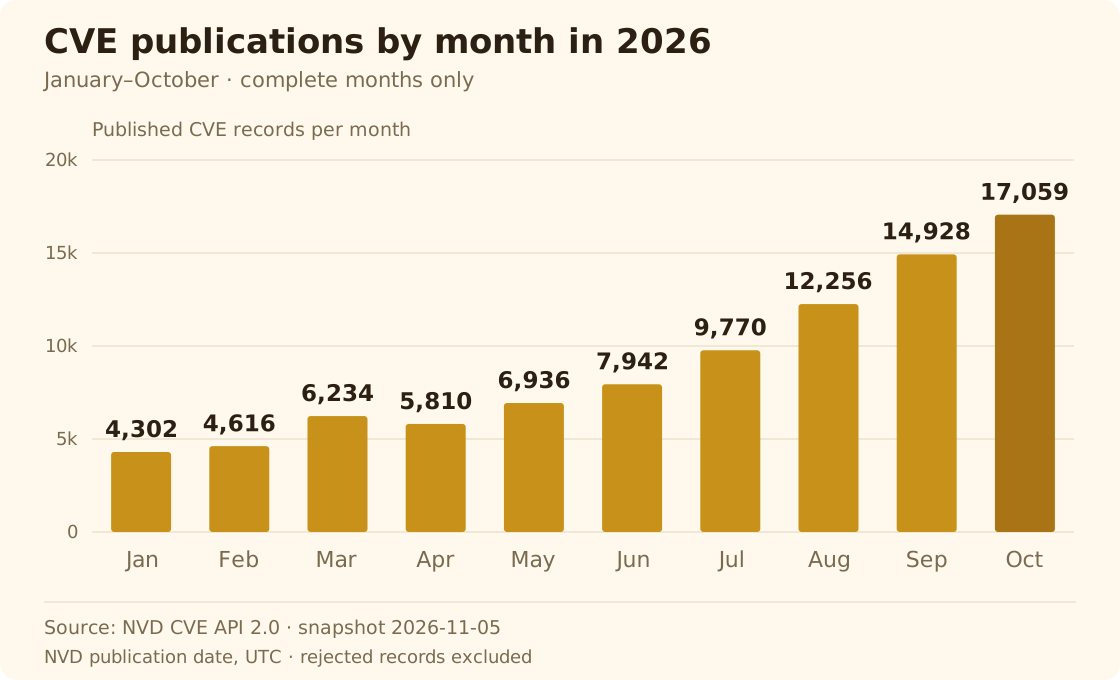
Но это число публикаций, а не ошибок, появившихся в конкретном году, и не число атак. Сам по себе этот рост не доказывает влияние ИИ: меняются и охват программы, и процесс регистрации уязвимостей. Например, сама CVE Program связывает рост публикаций с расширением сети CNA — организаций, которые присваивают идентификаторы и публикуют записи CVE.
На текущий момент апогеем этого стал «Чёрный октябрь 2026», на который пришлись:
- две критические уязвимости в PHP, позволяющие добиться RCE — php2shell, CVE-2026-109618 и CVE-2026-109619
- критическая уязвимость в TCP-стеке Linux с демонстрацией RCE на системах с MPTCP
- RCE в GitLab
- компрометация промежуточных сертификатов eMudhra (пожалуй, самый крупный инцидент WebPKI за более чем 30 лет)
- компрометация Railway
- и многое другое
Причём всё это произошло не просто в октябре, а примерно за неделю.
Показателен и темп атак. Глава Cloudflare Мэттью Принс писал 22 октября, что ещё за десять часов до публичного объявления php2shell сеть компании зафиксировала тысячи попыток эксплуатации. За первые 45 минут после объявления их число выросло до десятков тысяч, за два часа — до сотен тысяч, а к моменту его сообщения речь шла уже о миллионах.
Это именно попытки эксплуатации, а не миллионы успешных взломов. Но рассчитывать на несколько спокойных дней между публикацией критической уязвимости и началом массовых атак уже не приходится.
Акт 2. Проблема накопленных кодовых баз
Большая часть ПО, которым мы пользуемся, разрабатывалась десятилетиями. У меня давно есть мысль, что любая кодовая база по мере развития стремится к говну. Причём для этого совершенно необязательно нанимать плохих разработчиков.
Все могли делать вполне разумные вещи. Кто-то экономил память, другую команду поджимал релиз. Потом понадобилась обратная совместимость, сменился протокол, купили компанию вместе с её продуктом. Старое решение никто не убрал — поверх него пристроили новое.
Через двадцать лет у нас десятки слоёв чужих компромиссов. Половину уже никто не может объяснить, зато все знают, что трогать их нельзя. И вот эту конструкцию мы называем зрелой, проверенной временем системой. Выглядеть она при этом может примерно так:
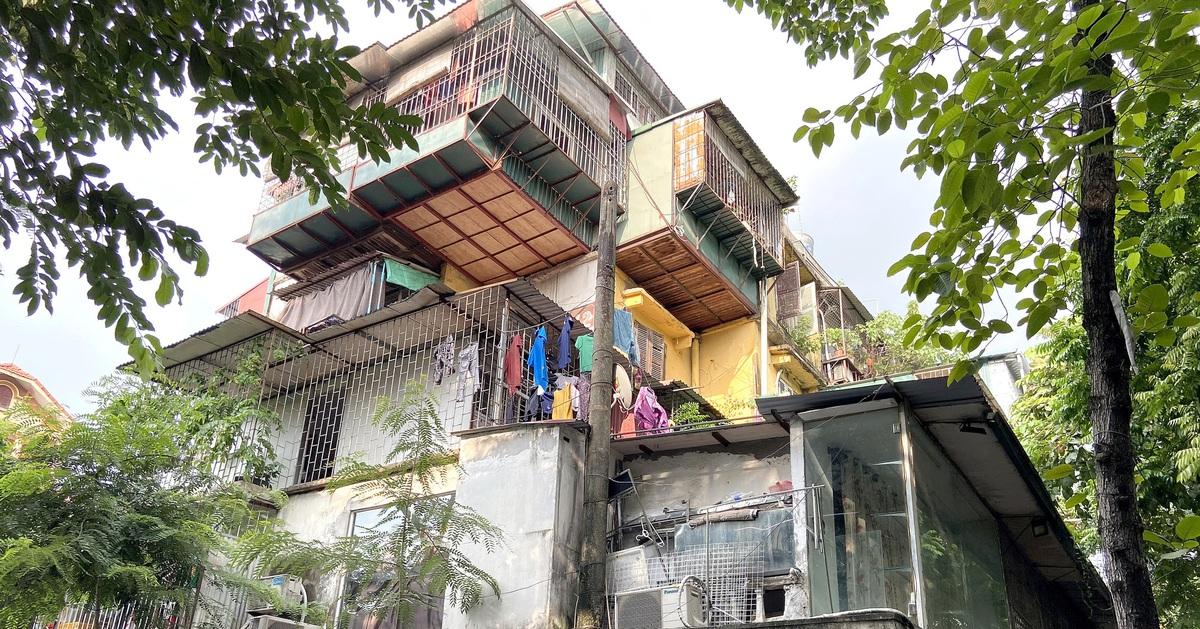
Всё это и раньше напоминало дженгу: компоненты вроде бы работают, но вытаскивать любой из них страшно. Теперь эту конструкцию будут гораздо активнее проверять на прочность.
И это не преувеличение. В Azure API Connections исследователь раз за разом обходил исправления: сервис обладал избыточными полномочиями, а закрывать проблему пытались проверками URL. После одного из патчей снова заработал предыдущий обход.
Показательный пример большой кодовой базы — Linux. Ядро разрабатывается больше тридцати лет, к нему приложили руку тысячи людей. Это десятки миллионов строк кода, на которых держится огромное количество систем, в том числе критических. Его монолитную архитектуру критиковали ещё на заре разработки — достаточно вспомнить Таненбаума. Компрометация ядра может отдать атакующему всю систему, поэтому ошибки на этом уровне обходятся особенно дорого. Дальше я буду говорить в первую очередь именно о Linux.
Акт 3. Код больше ничего не стоит
Но при всей критике Linux заменить его — задача совершенно другого масштаба, чем просто написать своё небольшое ядро. Обеспечить поддержку оборудования, необходимых протоколов и приложений, а затем сделать всё это новым стандартом — совсем другая история.
В 2008 году стоимость повторной разработки ядра Linux с нуля оценивали в $1,4 млрд, а в 2011 — уже примерно в $3 млрд. С тех пор кодовая база выросла в несколько раз. Понятно, что такие расчёты условны, но порядок затрат они показывают.
Только эти оценки предполагали, что код пишут люди. С агентами он обходится дешевле и появляется быстрее.
«Но агенты же могут чинить старый код?» Конечно могут. И будут. Только иногда чинить приходится уже само устройство системы. Если сервису выдали доступ ко всему подряд, а безопасность держится на том, что разработчики не забыли проверить очередной способ к нему обратиться, можно ещё долго коллекционировать CVE.
Мы привыкли, что переписывать большую систему с нуля — почти всегда плохая идея. Слишком долго, слишком дорого, слишком много всего сломается. Поэтому продолжаем подпирать старую конструкцию. Это был вполне разумный выбор, пока новую реализацию нужно было годами писать руками.
Но теперь эту смету стоит пересчитать. Возможно, очередные десять лет ремонта обойдутся дороже замены. Я думаю, именно к этому мы и идём.
В конечном счёте единственным полноценным решением проблемы бесконечного потока уязвимостей я считаю полное переписывание большей части ПО — в критических системах и не только.
Само по себе авторство агента ничего не исправляет. Если попросить его воспроизвести старую архитектуру, вместе с ней легко переедут и старые проблемы. Зато код будет свежий.
Переписывать нужно с учётом того, что мы уже успели узнать: где нельзя доверять входным данным, как разделить полномочия, какие классы ошибок вообще не стоит допускать. Будет это монолитное ядро или микроядерное — отдельный разговор. Но просто сменить автора у старых ошибок недостаточно.
Весь этот код, который мы десятилетиями писали руками, действительно могут переписать агенты. Можно поставить его в рамочку, всплакнуть над красивой абстракцией и пойти дальше.
Но что тогда останется от нашей работы? Поведение системы. Решения о том, что она должна делать, с чем быть совместимой и чего не должна позволять ни при каких условиях. По-хорошему — спецификации.
Только значительная часть этих спецификаций сейчас существует в виде исходников. В странной проверке, которую однажды добавили после инцидента. В порядке вызовов, который нельзя менять, иначе раз в месяц всё падает. Никто уже не помнит почему, но проверяли — падает.
И вот это знание придётся вытащить. Разобраться, какие из накопленных за годы костылей всё ещё нужны, а какие мы просто боимся трогать. Иначе агент добросовестно перепишет их все.
Мы действительно все эти годы просто писали разноцветные буковки в редакторе? Или всё-таки делали так, чтобы система приносила пользу людям и экономила деньги бизнесу? Если второе — замена исходников ещё не означает, что наш труд отправился на помойку.